1. 변수
변수(Variable)
프로그램에서 값을 저장하고 사용하기 위해 이름을 붙인 저장 공간이다
변수 이름을 통해 저장된 값을 읽거나 변경할 수 있다. 자료형에 따라 저장할 수 있는 값의 종류와 범위가 달라진다
int score = 20;
score = 30;
score라는 정수형 변수를 만들고 20으로 초기화한 뒤, 저장된 값을 30으로 변경한 코드이다
1.1 변수의 선언과 초기화
변수를 사용하려면 자료형과 변수 이름을 지정하여 선언한다
int a;
double b = 1.0;
char c = 'a'
선언문 끝에는 세미콜론 ;을 붙인다. 문자 리터럴은 작은 따옴표로 감싼다
초기화는 변수를 만들 때 처음 값을 지정하는 것이고, 대입은 이미 존재하는 변수에 값을 저장하는 것이다
int score = 20; //초기화
socre = 30;     //대입
같은 = 기호를 사용하지만, 변수를 만드는 시점인지에 따라 구분한다
초기화하지 않은 지역 변수
함수 안에서 선언한 일반적인 지역 정수형 변수는 자동으로 0이 되지 않는다. 값을 읽기 전에 초기화하거나 값을 대입해야 한다
1.2 변수의 유효 범위
유효 범위(Scope)
프로그램에서 변수 이름을 사용하여 해당 변수에 접근할 수 있는 코드 영역이다
변수를 선언한 위치에 따라 이름을 사용할 수 있는 범위가 달라진다
int a;

int main()
{
    int b;
    return 0;
}| 변수 | 선언 위치 | 이름을 사용할 수 있는 범위 |
|---|---|---|
| a | 함수 바깥 | 선언 이후 해당 이름이 보이는 영역 |
| b | main() 블록 안 | 선언 이후 해당 블록의 끝까지 |
1.2.1 전역 변수
함수 바깥에서 선언한 변수이다. 해당 이름이 보이는 여러 함수에서 접근할 수 있다
초기값을 명시하지 않은 전역 정수형 변수는 0으로 초기화된다
1.2.2 지역 변수
함수나 블록 {} 안에서 선언한 변수이다. 일반적으로 선언한 지점부터 해당 블록의 끝까지 이름을 사용할 수 있다
int main()
{
    int a = 10;

    {
        int b = 20;
        a = b; // 바깥 블록의 a에 접근 가능
    }

    b = 30; // 오류: b의 유효 범위를 벗어남

    return 0;
}
안쪽 블록에서는 바깥 블록의 a를 사용할 수 있지만, 바깥에서는 안쪽 블록의 b를 사용할 수 없다
1.3 변수 이름 작성 규칙
기본적인 영문 변수 이름에는 다음 문자를 사용할 수 있다
- 영문자: A,a ~Z,z
- 숫자: 0~9
- 밑줄:
_
단, 첫 글자로 숫자를 사용할 수 없으며, 공백과 하이픈 -도 사용할 수 없다
1.3.1 대소문자 구분
대문자와 소문자를 구분한다
int score;
int Score;
int SCORE;
세 이름은 서로 다른 변수를 나타낸다
1.3.2 키워드 사용 금지
키워드(keyword)
프로그래밍 언어에서 특정 의미와 기능을 갖도록 미리 정해 둔 단어이다. 변수 이름으로 사용할 수 없다
int, double, char, return 등이 해당한다
또한 C++에서는 밑줄 다음에 대문자가 오는 이름이나 __을 포함하는 이름 등이 구현용으로 예약되어 있다. student_id, totalScore처럼 의미가 분명하고 예약 규칙에 걸리지 않는 형태로 작성한다
2. 자료형과 auto
2.1 자료형
자료형(Data Type)
저장할 수 있는 값의 종류와 표현 범위, 메모리 크기, 적용할 수 있는 연산 등을 결정하는 형식이다
int count = 10;
double average = 85.5;
char grade = 'A';
bool passed = true;| 변수 | 자료형 | 저장된 값 |
|---|---|---|
| count | int | 정수 10 |
| average | double | 실수 85.5 |
| grade | char | 문자 'A' |
| passed | bool | 논리값 true |
2.2 기본 자료형
기본 자료형에는 정수형, 부동소수점형, 논리형 등이 있다. 다음 크기는 일반적인 Winodw의 MSVC 환경을 기준으로 한 예시이다
| 분류 | 자료형 | 용도 | 크기 예시 |
|---|---|---|---|
| 정수형 | char | 문자와 작은 정수 표현 | 1바이트 |
| 정수형 | short | 정수 표현 | 2바이트 |
| 정수형 | int | 일반적인 정수 표현 | 4바이트 |
| 정수형 | long | 정수 표현 | 4바이트 |
| 정수형 | long long | 큰 정수 표현 | 8바이트 |
| 부동소수점형 | float | 실수의 근삿값 표현 | 4바이트 |
| 부동소수점형 | double | float보다 높은 정밀도의 실수 표현 | 8바이트 |
| 부동소수점형 | long double | double 이상의 정밀도로 실수 표현 | 8바이트 |
| 논리형 | bool | true 또는 false 표현 | 1바이트 |
char는 문자를 표현하는 데 사용하지만, 자료형 분류상 정수형에 속한다
자료형 크기는 환경에 따라 달라진다
표의 크기를 모든 환경에 적용하면 안 된다. 예를 들어 64비트 Ubuntu에서는
long이 보통 8바이트이며,long double의 크기도 환경에 따라 다르다. 실제 크기는sizeof로 확인한다
2.2.1 정수형
소수 부분이 없는 값을 저장한다
int count = 10;
long long population = 8000000000LL;LL은 정수 리터럴이 long long형임을 나타내는 접미사이다
2.2.2 부동소수점형
소수 부분을 포함하는 수를 표현한다. 표현 가능한 정밀도가 제한되어 있으므로, 많은 실수는 정확한 값 대신 근삿값으로 저장된다
float x = 1.5f;
double y = 1.5;
long double z = 1.5L;| 리터럴 | 자료형 |
|---|---|
1.5f | float |
1.5 | double |
1.5L | long double |
2.2.3 논리형
bool은 참과 거짓을 나타낸다
bool passed = true;
bool finished = false;
숫자를 bool로 변환할 때는 0이면 false 아니면 true가 된다
2.3 정수형의 최소 표현 범위와 크기 관계
C++는 정수형의 크기를 모두 고정하지 않고, 최소 표현 범위와 자료형 사이의 크기 관계를 보장한다
| 자료형 | 최소 표현 범위에 필요한 비트 수 | 크기 관계 |
|---|---|---|
short | 최소 16비트 | char 이상 |
int | 최소 16비트 | short 이상 |
long | 최소 32비트 | int 이상 |
long long | 최소 64비트 | long 이상 |
크기 관계는 다음과 같다
자료형 이름이 다르더라도 크기는 같을 수 있다. 예를 들어 Window의 일반적인 MSVC 환경에서는 int와 long이 모두 4바이트다
2.4 sizeof로 크기 확인
sizeof자료형이나 객체가 차지하는 크기를 바이트 단위로 구하는 연산자이다
int num = 10;

sizeof(int); // int형의 크기
sizeof(num); // num의 크기int가 4바이트인 환경에서는 두 식의 결과가 모두 4이다
2.4.1 저장된 값과 크기의 관계
같은 자료형의 변수는 저장된 값이 바뀌어도 크기가 변하지 않는다
sizeof 결과의 자료형은 크기를 표현하는 부호 없는 정수형인 std::size_t이다. 또한 sizeof(char)는 항상 1이다
2.4.2 정수형의 표현 범위 확인
<climits>: 정수형의 최솟값과 최댓값을 나타내는 상수 매크로를 제공하는 헤더 파일
| 상수 | 의미 |
|---|---|
SHRT_MIN, SHRT_MAX | short의 최솟값과 최댓값 |
INT_MIN, INT_MAX | int의 최솟값과 최댓값 |
LONG_MIN, LONG_MAX | long의 최솟값과 최댓값 |
LLONG_MIN, LLONG_MAX | long long의 최솟값과 최댓값 |
#include <climits>
#include <iostream>

int main()
{
    std::cout << INT_MIN << '\n';
    std::cout << INT_MAX << '\n';

    return 0;
}std::cout는 화면에 데이터를 출력할 때 사용하는 표준 출력 스트림 객체이다
2.5 auto를 이용한 자료형 추론
auto변수의 자료형을 직접 적는 대신, 초기화에 사용하는 식으로부터 컴파일러가 자료형을 추론하도록 하는 키워드이다
auto n = 100;
auto x = 1.5;
auto ch = 'A';
auto passed = true;| 선언 | 추론된 자료형 |
|---|---|
auto n = 100; | int |
auto x = 1.5; | double |
auto ch = 'A'; | char |
auto passed = true; | bool |
위와 같은 변수 선언에서는 자료형을 추론할 초기값이 필요하다
자료형은 컴파일할 때 결정된다. auto로 선언해도 변수의 자료형이 실행 중 바뀌지는 않는다
auto n = 100; // n의 자료형은 int
n = 3.5; // int로 변환되어 3이 저장됨3.5를 대입했다고 n이 double형으로 바뀌는 것은 아니다. 이미 결정된 int형에 맞추어 값이 변환된다
3. 연산자
연산자(Operator)
값이나 변수에 대해 계산, 비교, 대입 등의 연산을 수행하는 기호이다. 연산의 대상이 되는 값이나 식을 피연산자(Operand)라고 한다
C++의 기본 연산자는 C와 대부분 유사하다. 여기서는 기본 자료형에 적용하는 내장 연산자를 다룬다
연산자의 종류
| 분류 | 연산자 | 역할 |
|---|---|---|
| 증가와 감소 | ++, — | 값을 1 증가시키거나 감소 |
| 산술 | +, -, *, /, % | 사칙연산과 나머지 계산 |
| 단항 부호 | +a, -a | 수의 부호에 관한 연산 |
| 비교 | ==, !=, <, <=, >, >= | 두 값의 관계 비교 |
| 비트 | &, |, ^, ~, <<, >> | 비트 단위 연산 |
| 논리 | &&, |, ! | 참과 거짓에 대한 연산 |
| 조건 | 조건 ? 식1 : 식2 | 조건에 따라 식 선택 |
| 대입 | = | 변수 등에 값을 저장 |
| 복합 대입 | +=, -=, *=, /=, %= 등 | 연산 결과를 다시 저장 |
| 쉼표 | 식1, 식2 | 왼쪽 식을 평가한 뒤 오른쪽 식을 평가 |
| 기타 | sizeof, 형 변환 등 | 크기 확인, 자료형 변환 등 |
3.1 증가와 감소 연산자
++는 값을 1 증가시키고, —는 값을 1 감소시킨다. 기호의 위치에 따라 전위형과 후위형으로 나뉜다
| 형태 | 의미 |
|---|---|
| ++a | 증가한 값을 식에서 사용 |
| a++ | 증가 전 값을 식에서 사용 |
| —a | 감소한 값을 식에서 사용 |
| a— | 감소 전 값을 식에서 사용 |
int a = 3;
int b = ++a; // a = 4, b = 4

int x = 3;
int y = x++; // x = 4, y = 3
두 경우 모두 원래 변수는 1 증가하지만, 다른 변수에 저장되는 값이 다르다
독립된 문장으로 사용하고 결과값을 사용하지 않는다면, 다음 두 문장은 모두 a를 1 증가시킨다
++a;
a++;
3.2 산술 연산자
| 연산자 | 의미 | 식 | 결과 |
|---|---|---|---|
| + | 덧셈 | 7 + 2 | 9 |
| - | 뺄셈 | 7 - 2 | 5 |
| * | 곱셈 | 7 * 2 | 14 |
| / | 나눗셈 | 7 / 2 | 3 |
| % | 나머지 | 7 % 2 | 1 |
3.2.1 정수 나눗셈과 실수 나눗셈
두 피연산자가 모두 정수형이면 정수 나숫셈을 수행하며, 소수 부분은 0을 향해 버린다
7 / 2;    // 3
7.0 / 2;  // 3.5
결과를 실수형 변수에 저장하더라도, 나눗셈 자체가 먼저 수행된다
double a = 7 / 2;   // 3.0
double b = 7.0 / 2; // 3.5
%는 정수형 피연산자의 나머지를 구하는 데 사용한다. 정수 나숫셈과 나머지 연산에서 오른쪽 피연산자가 0이면 정의되지 않은 동작이 발생한다
3.2.2 단항 부호 연산자
int a = 5;
int b = -a; // -5
-a는 부호를 반전한 값을 만들지만, 이 식만으로 a자체가 변경되지는 않는다
3.3 비교 연산자
두 값을 비교한 결과를 bool형인 true 또는 false로 나타낸다
| 연산자 | 의미 |
|---|---|
| == | 같다 |
| != | 다르다 |
| < | 작다 |
| <= | 작거나 같다 |
| > | 크다 |
| >= | 크거나 같다 |
int a = 10;
int b = 20;

a == b; // false
a != b; // true
a < b;  // true
=는 대입이고, ==는 비교이다
3.4 논리 연산자
참과 거짓을 조합하거나 반전한다. 숫자를 논리값으로 해석할 때는 0이 거짓이고, 0이 아닌 값은 참이다
| 연산자 | 의미 | 참이 되는 조건 |
|---|---|---|
| && | AND | 양쪽 모두 참 |
| || | OR | 적어도 한쪽이 참 |
| ! | NOT | 피연산자가 거짓 |
int score = 85;

bool passed = score >= 60 && score <= 100; // true
bool invalid = score < 0 || score > 100;   // false
bool failed = !passed;                    // false
3.4.1 단락 평가
단락 평가(Short-circuit Evaluation)
논리식의 결과가 왼쪽 피연산자만으로 결정되면 오른쪽 피연산자를 평가하지 않는 것이다
&&: 왼쪽이 거짓이면 오른쪽을 평가하지 않는다||: 왼쪽이 참이면 오른쪽을 평가하지 않는다
int divisor = 0;

bool result = divisor != 0 && 10 / divisor > 2;
divisor != 0이 거짓이므로 오른쪽의 나눗셈은 수행하지 않는다. 따라서 이 식에서는 0으로 나누는 연산을 피할 수 있다
3.5 비트 연산자
정수의 각 비트를 대상으로 연산한다
| 연산자 | 의미 |
|---|---|
| & | 두 비트가 모두 1이면 1 |
| | | 두 비트 중 하나 이상이 1이면 1 |
| ^ | 두 비트가 서로 다르면 1 |
| ~ | 각 비트를 반전 |
| << | 비트를 왼쪽으로 이동 |
| >> | 비트를 오른쪽으로 이동 |
unsigned int a = 6; // 이진수 110
unsigned int b = 3; // 이진수 011

a & b; // 010 → 2
a | b; // 111 → 7
a ^ b; // 101 → 5
비트 이동은 다음과 같이 사용할 수 있다
unsigned int x = 3; // 이진수 0011

x << 1; // 0110 → 6
x >> 1; // 0001 → 1
위 식들은 계산 결과를 만들며, x에 대사 대입하지 않으면 x 자체는 변경되지 않는다
3.5.1 비트 연산과 논리 연산의 차이
| 구분 | 비트 연산 | 논리 연산 |
|---|---|---|
| 연산 대상 | 각 비트 | 참과 거짓 |
| AND | & | && |
| OR | || | | |
| 반전 | ` | ! |
| 단락 평가 | 없음 | &&, ||에 있음 |
6 & 3;  // 2
6 && 3; // true
6 && 3은 두 값이 모두 0이 아니므로 참이다
3.6 조건 연산자
조건의 참과 거짓에 따라 두 식 중 하나를 선택한다
조건 ? 참일_때의_식 : 거짓일_때의_식예시:
int a = 10;
int b = 20;

int maxValue = (a > b) ? a : b; // 20
조건이 참이면 a, 거짓이면 b를 선택한다. 선택된 쪽은 식만 평가한다
3.7 대입과 복합 대입 연산자
대입 연산자 =는 오른쪽 값을 왼쪽 대상에 저장한다. 복합 대입은 계산과 대입을 함께 수행한다
| 표현 | 기본 변수에 대한 대응 표현 |
|---|---|
| a += b | a = a + b |
| a -= b | a = a - ` |
| a *= b | a = a * b |
| a /= b | a = a / b |
| a %= b | a = a % b |
| a &= b | a = a & b |
int score = 10;

score += 5; // 15
score *= 2; // 30
엄밀하게는 복합 대입에서 왼쪽 피연산자는 한 번만 평가되므로, 복잡한 식에서는 단순히 풀어 쓴 표현과 차이가 있을 수 있다
3.8 쉼표 연산자
쉼표 연산자는 왼쪽 식을 먼저 평가한 뒤, 오른쪽 식을 평가하고 그 결과를 전체 식의 결과로 사용한다
int a;
int b;

a = (b = 3, b + 2);- b = 3을 실행 한다
- b + 2를 계산하여 5를 얻는다
- 전체 괄호 식의 결과인 5를 a에 저장한다
최종 결과는 a = 5, b = 3이다
함수 인수나 변수 선언을 구분하는 쉼표는 쉼표 연산자가 아니다
int a, b;   // 선언 구분
func(a, b); // 인수 구분
3.9 연산자 우선순위와 괄호
여러 연산자가 하나의 식에 있으면 우선순위에 따라 식이 묶인다
int x = 2 + 3 * 4;   // 14
int y = (2 + 3) * 4; // 20
자주 사용하는 연산자의 상대적인 우선순위는 다음과 같다. 위쪽일수록 높다
| 순서 | 연산자 |
|---|---|
| 높음 | 후위 ++, — |
| ↓ | 전위 ++, —, !, ~, 단항 +, -, sizeof |
| ↓ | *, /, % |
| ↓ | +, - |
| ↓ | <<, >> |
| ↓ | <, <=, >, >= |
| ↓ | ==, != |
| ↓ | 비트 & → ^ → || |
| ↓ | 논리 && → | |
| ↓ | 조건 ?: |
| ↓ | 대입과 복합 대입 |
| 낮음 | 쉼표 연산자 |
우선순위와 실행 순서는 다르다
우선순위는 식을 어떻게 묶어 해석할지를 정하는 규칙이다. 모든 피연산자의 실행 순서를 정하는 규칙은 아니다. 해석이 헷갈리는 식은 괄호로 의도를 명확하게 표현한다
4. 변수의 값, 주소, 크기
변수를 이해할 때는 저장되는 값, 메모리 주소, 차지하는 크기를 구분해야 한다
int num = 5;| 표현 | 의미 | 결과 예시 |
|---|---|---|
| num | 변수에 저장된 값 | 5 |
| &num | 변수의 메모리 주소 | 실행 환경에 따라 다름 |
sizeof(num) | 변수가 차지하는 크기 | int가 4바이트라면 4 |
4.1 변수의 값과 메모리 표현
변수에 값을 저장하면 해당 자료형의 표현 방식에 따라 메모리에 저장된다
저장된 값이 크다고 해서 같은 int형 변수의 크기가 커지는 것은 아니다. 자료형이 같으면 값이 달라도 크기는 같다
4.2 변수의 주소와 주소 연산자
메모리 주소(Memory Address)
메모리에서 데이터가 저장된 위치를 식별하는 값이다
일반적인 바이트 단위 주소 체계에서는 각 바이트에 주소가 부여된다. 여러 바이트를 차지하는 변수의 주소는 해당 저장 공간의 시작 위치를 나타낸다
주소 연산자(Address-of Operator)
변수 앞에 &를 붙여 해당 변수의 메모리 주소를 구하는 단항 연산자이다
int num = 5;

# // num의 주소를 구하는 식
num과 &num은 서로 다른 의미를 가진다
| 표현 | 의미 | 자료형 |
|---|---|---|
| num | 값을 읽는 문맥에서 정수 5 | int |
| &num | num을 가리키는 주소 | int* |
int* 는 정수형 객체를 가리키는 포인터형이며, 자세한 내용은 초인터 단윈에서 다룬다
4.2.1 &의 의미 구분
같은 기호라도 사용 위치에 따라 의미가 다르다
#  // 주소 연산자
a & b; // 비트 AND 연산자
주소 연산자는 피연산자가 하나이고, 비트 AND 연산자는 피연산자가 두 개이다
4.3 변수의 크기
sizeof를 사용하면 변수의 크기를 바이트 단위로 확인할 수 있다
int num = 5;

sizeof(num); // num의 크기
sizeof(int); // int형의 크기
num의 자료형이 int이므로 두 결과는 같다
값을 변경해도 num의 자료형과 크기는 변하지 않는다
4.4 값, 주소, 크기 출력
다음 코드에서 각 표현이 무엇을 출력하는지 구분할 수 있다
int num1 = 4;
int num2 = 5;

std::cout << num1 << " "
          << &num1 << " "
          << sizeof(num1) << '\n';

std::cout << num2 << " "
          << &num2 << " "
          << sizeof(num2) << '\n';
각 줄의 출력 순서는 다음과 같다
| 출력 항목 | 첫 번째 줄 | 두 번째 줄 |
|---|---|---|
| 값 | 4 | 5 |
| 주소 | num1의 주소 | num2의 주소 |
| 크기 | sizeof(int) | sizeof(int) |
주소는 일반적으로 16진수 형태로 표시되며, 실제 출력값은 실행 환경과 실행 시점에 따라 달라질 수 있다
별개 변수의 메모리 배치는 보장되지 않는다
별도로 선언한 지역 변수가 항상 선언 순서대로 연속 배치되는 것은 아니다.
int가 4바이트라고 해서 두 변수의 주소 차이도 반드시 4바이트라고 판단하면 안 된다
5. 프로그램의 메모리 구조
프로그램이 실행되면 실행 명령어와 데이터를 저장할 메모리가 필요하다. 일반적인 C/C++ 프로그램의 메모리 구조는 다음과 같이 구분한다
| 영역 | 주요 저장 내용 |
|---|---|
| 스택(Stack) | 일반적인 지역 변수, 함수 매개변수, 복귀 주소 등 |
| 힙(Heap) | 동적으로 할당한 메모리 |
| 초기화된 데이터 영역(Data) | 0이 아닌 초기값이 있는 전역 변수와 정적 변수 등 |
| BSS 영역 | 초기값을 명시하지 않았거나 0으로 초기화된 전역 변수와 정적 변수 등 |
| 코드 영역(Text) | 컴파일된 실행 명령어 |
이 구조는 일반적인 실행 환경을 설명하는 모델이다. 실제 배치는 운영체제, 컴파일러, 최적화 등에 따라 달라질 수 있다
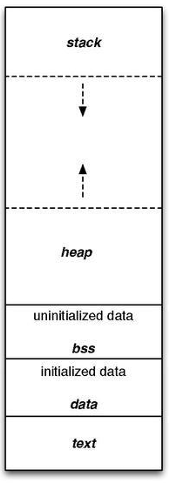
5.1 스택
스택(Stack)
함수 호출과 실행에 필요한 정보를 관리하는 메모리 영역이다. 함수 호출 시 필요한 공간을 확보하고, 함수가 끝나면 해당 공간을 회수하는 방식으로 사용된다
일반적으로 다음 정보가 저장된다
- 함수 안에서 선언한 자동 지역 변수
- 함수 매개변수
- 함수 실행을 마친 뒤 돌아갈 위치인 복귀 주소
void func(int value)
{
    int result = value + 1;
}
value와 result는 일반적으로 함수 호출에 필요한 스택 공간과 관련된다. 다만 최적화에 따라 레지스터에 저장되거나 실제 저장 공간이 생략될 수도 있다
5.1.1 함수 호출과 스택의 변화
함수 main()에서 func()를 호출하면 다음과 같이 동작한다
main()실행에 필요한 정보가 유지된다func()실행에 필요한 공간이 추가된다func()가 끝나면 해당 공간이 회수된다main()으로 돌아와 실행을 계속한다
나중에 호출한 함수가 먼저 종료되는 후입선출(LIFO) 구조로 이해할 수 있다
5.2 힙
힙(Heap)
프로그램 실행 중 필요에 따라 메모리를 동적으로 할당하는 데 사용하는 영역이다
| 언어 | 할당 | 해제 |
|---|---|---|
| C | malloc() 등 | free() |
| C++ | new, new[] | delete, delete[] |
void func()
{
    int* ptr = new int(10);

    delete ptr;
}
여기서는 포인터 변수와 포인터가 가리키는 객체의 저장 공간을 구분해야 한다
| 대상 | 일반적인 저장 위치 |
|---|---|
| 지역 포인터 변수 ptr | 스택 |
new int(10)으로 생성한 정수 객체 | 힙 |
ptr에는 동적으로 생성한 정수 객체의 주소가 저장된다
포인터의 수명과 동적 메모리의 수명
지역 포인터 변수가 속한 블록이 끝나도 그 포인터가 가리키는 동적 메모리까지 자동으로 해제되지는 않는다. 직접 할당한 메모리를 적절하게 해제하지 않으면 메모리 누수가 발생할 수 있다
C++에서는 컨테이너와 스마트 포인터를 활용하여 동적 메모리의 수명을 자동으로 관리할 수도 있다
5.3 데이터 영역과 BSS 영역
전역 변수와 정적 변수처럼 프로그램 실행 동안 저장 공간이 유지되는 데이터를 보관하는 데 사용된다
5.3.1 초기화된 데이터 영역
일반적으로 0이 아닌 초기값이 있는 전역 변수와 정적 변수가 저장된다
int total = 25;

void func()
{
    static int count = 10;
}
total과 count는 일반적으로 초기화된 데이터 영역에 배치된다.
count는 함수 안에서 선언했지만 static 지역 변수이므로, 일반적인 자동 지역 변수처럼 함수가 끝날 때 사라지지 않는다
5.3.2 BSS 영역
BSS 영역
일반적으로 초기값을 명시하지 않았거나 0으로 초기화된 전역 변수와 정적 변수를 위한 메모리 영역이다
int total;
int count = 0;

void func()
{
    static int calls;
}
위 변수들은 모두 0으로 초기화되며, 일반적으로 BSS 영역에 배치된다
| 선언 | 초기값 | 일반적인 배치 |
|---|---|---|
전역 int a = 10; | 10 | 초기화된 데이터 영역 |
전역 int b; | 0 | BSS 영역 |
전역 int c = 0; | 0 | BSS 영역 |
지역 static int d; | 0 | BSS 영역 |
일반적인 지역 int e; | 자동으로 0이 되지 않음 | 스택 또는 레지스터 등 |
초기값이 없다는 이유만으로 모두 BSS에 저장되는 것은 아니다. 일반적인 자동 지역 변수와 전역 변수 또는 정적 변수를 구분해야 한다
5.4 코드 영역
코드 영역(Text)
소스 코드를 컴파일하여 만든 실행 명령어가 저장되는 메모리 영역이다
int add(int a, int b)
{
    return a + b;
}add()가 수행할 연산을 나타내는 실행 명령어는 코드 영역에 저장된다. 호출할 때 전달되는 a, b의 값과 함수의 실행 명령어는 서로 구분된다
코드 영역은 일반적으로 쓰기가 제한되어 실행 명령어가 임의로 변경되지 않도록 보호된다
5.5 선언에 따른 메모리 영역 구분
int total = 25;
int count;

int main()
{
    int value = 10;
    static int calls = 0;
    int* ptr = new int(20);

    delete ptr;

    return 0;
}| 대상 | 일반적인 배치 | 설명 |
|---|---|---|
| total | 초기화된 데이터 영역 | 0이 아닌 초기값이 있는 전역 변수 |
| count | BSS 영역 | 초기값을 명시하지 않은 전역 변수 |
| value | 스택 | 자동 지역 변수 |
| calls | BSS 영역 | 0으로 초기화된 정적 지역 변수 |
| ptr | 스택 | 동적 객체의 주소를 저장하는 지역 변수 |
new int(20)으로 생성한 객체 | 힙 | 실행 중 동적으로 생성한 객체 |
main()의 실행 명령어 | 코드 영역 | 컴파일된 명령어 |
메모리 영역을 구분할 때는 선언 위치뿐 아니라 static 여부와 동적 할당 여부도 함께 확인해야 한다
6. 포인터와 간접 참조
6.1 포인터
포인터 변수(Pointer Variable)
주소 값을 저장하는 변수이다. 객체를 가리키는 유효한 포인터를 통해 해당 객체에 접근할 수 있다
int num = 5;
int* pnum = #| 표현 | 의미 |
|---|---|
| num | 정수 값을 저장하는 변수 |
| &num | 변수 num의 주소 |
| pnum | num의 주소를 저장하는 포인터 변수 |
*pnum | pnum이 가리키는 객체인 num에 접근하는 식 |
pnum에 저장되는 것은 정수 5가 아니라 num의 주소이다
6.2 포인터의 선언과 초기화
포인터는 가리킬 대상의 자료형에 *를 붙여 선언한다
int num = 5;
double value = 1.5;
char ch = 'A';

int* pnum = #
double* pvalue = &value;
char* pch = &ch;| 포인터 자료형 | 가리키는 대상 |
|---|---|
int* | int형 객체 |
double* | double형 객체 |
char* | char형 객체 |
일반적으로 포인터형과 가리키는 객체의 자료형이 맞아야 한다
int num = 5;

int* pnum = #       // 가능
double* ptr = #  // 오류: 포인터 자료형 불일치
6.2.1 선언에서 *의 적용 범위
한 문장에서 여러 변수를 선언할 때는 각 변수의 선언을 따로 확인해야 한다
int* p, value;위 코드에서 p는 포인터지만, value는 일반적인 int형 변수이다
int* p;
int value;
혼동을 줄이려면 변수마다 선언문을 나누어 작성할 수 있다
6.3 간접 참조 연산자 *
간접 참조(Indirection)
포인터를 통해 포인터가 가리키는 객체에 접근하는 것이다. 역참조(Dereference)라고도 하며, 단항 연산자
*를 사용한다
int num = 5;
int* pnum = #

int value = *pnum;*pnum을 통해 num의 값을 읽으므로 value에는 5가 저장된다
*pnum = 20;이번에는 pnum이 가리키는 객체에 20을 대입하므로 num의 값이 변경된다
| 실행한 코드 | num | value |
|---|---|---|
int value = *pnum; | 5 | 5 |
*pnum = 20; | 20 | 5 |
value는 읽어 온 값을 복사한 별도의 변수이다. 이후 num을 변경해도 value가 함께 변경되지는 않는다
*의 의미 구분
| 코드 | *의 역할 |
|---|---|
int* pnum; | 포인터형을 선언하는 기호 |
*pnum | 포인터가 가리키는 객체에 접근 |
a * b | 두 값을 곱하는 연산자 |
6.4 포인터의 값과 대상의 값
포인터 자체를 변경하는 것과 포인터가 가리키는 객체를 변경하는 것은 다르다
int num1 = 10;
int num2 = 20;
int* pnum = &num1;
6.4.1 가리키는 객체의 값 변경
*pnum = 100;pnum은 여전히 num1을 가리키며, num1의 값이 100으로 변경된다
6.4.2 가리키는 대상 변경
pnum = &num2;pnum에 저장된 주소가 바뀌어 이제 num2를 가리킨다. 이 대입만으로 num1이나 num2의 값이 바뀌지는 않는다
6.5 포인터 변수 자신의 주소
포인터 변수도 하나의 객체이므로 자신의 주소를 가진다
int num = 5;
int* pnum = #| 표현 | 의미 | 자료형 |
|---|---|---|
| &num | num의 주소 | int* |
| pnum | 저장된 주소, 즉 &num | int* |
| &pnum | 포인터 변수 pnum 자신의 주소 | int** |
*pnum | num에 접근하는 식 | int형 객체를 나타냄 |
pnum과 &pnum은 서로 다른 객체의 주소이다. 하나는 num의 주소이고, 다른 하나는 포인터 변수 자체의 주소이다
6.6 이중 포인터
이중 포인터(Double Pointer)
포인터 객체를 가리키는 포인터이다. 예를 들어
int**는int*형 객체를 가리킨다
int num = 5;
int* pnum = #
int** ppnum = &pnum;| 표현 | 의미 |
|---|---|
| ppnum | pnum의 주소 |
*ppnum | 포인터 변수 pnum에 접근 |
**ppnum | pnum이 가리키는 num에 접근 |
따라서 다음 대입은 num을 변경한다
**ppnum = 30; // num은 30반면 다음 대입은`pnum이 가리키는 대상을 변경한다
int other = 100;

*ppnum = &other; // pnum이 other를 가리키도록 변경
이후 **ppnum을 읽으면 other의 값인 100을 얻는다
6.7 널 포인터와 유효한 접근
널 포인터는 객체나 함수를 가리키지 않는 포인터 값이다. C++에서는 nullptr로 표현한다
int* ptr = nullptr;나중에 유효한 객체의 주소를 대입한 뒤 사용할 수 있다
int num = 10;

ptr = #
*ptr = 20; // num은 20
유효하지 않은 포인터의 간접 참조
초기화하지 않은 포인터, 널 포인터, 수명이 끝난 객체를 가리키는 포인터를 통해 값을 읽거나 쓰면 안 된다. 간접 참조 전에 접근 가능한 객체를 올바르게 가리키는지 확인해야 한다
int* ptr = nullptr;

// *ptr = 10; // 잘못된 접근: 가리키는 객체가 없음
포인터가 nullptr이 아니라는 사실만으로 유효성이 보장되지는 않는다. 이미 수명이 끝난 객체의 주소가 남아 있을 수도 있기 때문이다
7. 배열과 포인터
7.1 배열
배열(Array)
같은 자료형의 원소를 연속된 메모리 공간에 저장하는 자료구조이다. 각 원소에는 인덱스를 사용하여 접근한다
int arr[3] = {10, 20, 30};| 표현 | 의미 | 값 |
|---|---|---|
arr[0] | 첫 번째 원소 | 10 |
arr[1] | 두 번째 원소 | 20 |
arr[2] | 세 번째 원소 | 30 |
배열의 인덱스는 0부터 시작한다. 원소가 3개인 배열에서 유효한 인덱스는 0부터 2까지이다
각 원소는 연속해서 배치되므로, 인접한 원소의 시작 주소는 원소 하나의 크기만큼 차이가 난다. int가 4바이트라면 인접한 원소는 4바이트 간격으로 배치된다
배열 이름은 많은 식에서 첫 번빼 원소를 가리키는 포인터로 변환된다
int arr[3] = {10, 20, 30};
int* ptr = arr;
위 초기화에서 arr는 &arr[0]과 같은 주소를 나타내는 포인터로 변환된다
배열과 포인터는 같은 자료형이 아니다
배열 이름이 첫 원소의 포인터로 변환될 수 있다는 것이 배열 자체가 포인터 변수라는 뜻은 아니다. 배열은 원소들을 저장하고, 포인터 변수는 주소를 저장한다
7.2 포인터 연산과 배열 원소 접근
포인터에 정수를 더하면 가리키는 자료형의 원소 수만큼 이동한 위치를 나타낸다
int arr[3] = {10, 20, 30};
int* ptr = arr;| 표현 | 가리키는 대상 | 간접 참조 결과 |
|---|---|---|
ptr | arr[0] | *ptr → 10 |
ptr + 1 | arr[1] | *(ptr + 1) → 20 |
ptr + 2 | arr[2] | *(ptr + 2) → 30 |
ptr + 1은 주소를 무조건 1바이트 증가시키는 연산이 아니다. int*라면 int 원소 하나만큼 이동한다
배열 원소 접근은 다음과 같이 표현할 수 있다
arr[1];       // 20
*(arr + 1);   // 20
ptr[1];       // 20
*(ptr + 1);   // 20
이 관계를 일반화하면 다음과 같다
arr[i] == *(arr + i)포인터를 통해 원소의 값을 변경할 수도 있다
*(ptr + 1) = 100; // arr[1]이 100으로 변경7.3 배열 이름과 포인터 변수의 차이
7.3.1 가리키는 대상 변경
포인터 변수에는 다른 주소를 대입할 수 있다
int arr1[3] = {10, 20, 30};
int arr2[3] = {40, 50, 60};

int* ptr = arr1;
ptr = arr2; // 가능
반면 배열 자체에는 다른 배열이나 주소를 대입할 수 없다. 배열 원소의 값을 변경하는 것은 가능하다
7.3.2 증가 연산
포인터 변수는 유효한 배열 범위 안에서 증가시킬 수 있다
int* ptr = arr1;
++ptr; // arr1[1]을 가리킴
배열 이름에는 증가 연산을 적용할 수 없다
| 구분 | 배열 arr1 | 포인터 변수 ptr |
|---|---|---|
| 저장하는 내용 | 여러 원소 | 주소 |
| 다른 주소 대입 | 불가능 | 가능 |
| ++ 적용 | 불가능 | 유효한 범위 내에서 가능 |
| 원소 접근 | arr1[i] | ptr[i] |
7.4 sizeof의 차이
sizeof의 피연산자로 사용한 배열은 첫 원소의 포인터로 변환되지 않는다
int arr[3] = {10, 20, 30};
int* ptr = arr;| 표현 | 의미 |
|---|---|
sizeof(arr) | 배열 전체의 크기 |
sizeof(arr[0]) | 원소 하나의 크기 |
sizeof(ptr) | 포인터 변수 자체의 크기 |
sizeof(*ptr) | 포인터가 가리키는 자료형의 크기 |
int가 4바이트라면 다음과 같다
sizeof(arr);    // 12
sizeof(arr[0]); // 4
sizeof(*ptr); // 4sizeof(ptr)는 포인터의 크기이며, 일반적인 64비트 환경에서는 8바이트인 경우가 많다. 가리키는 배열의 원소 수와는 관계없다
7.4.1 배열의 원소 수 계산
배열 전체 크기를 원소 하나의 크기로 나누면 원소 수를 얻을 수 있다
sizeof(arr) / sizeof(arr[0]) // 3단, 이 식은 arr가 실제 배열일 때 적용해야 한다. 포인터로는 가리키는 배열의 전체 크기를 알 수 없다
7.5 배열 전체의 주소와 첫 원소의 주소
다음 두 식은 시작 위치는 같지만 포인터 자료형이 다르다
int arr[3] = {10, 20, 30};

&arr[0]; // 첫 번째 원소의 주소
&arr; // 배열 전체의 주소| 표현 | 자료형 | 의미 |
|---|---|---|
&arr[0] | int* | 정수 원소를 가리키는 포인터 |
&arr | int (*)[3] | 정수 3개로 이루어진 배열을 가리키는 포인터 |
따라서 1을 더했을 때 이동 단위도 다르다
| 표현 | 이동 단위 |
|---|---|
arr + 1 | int 원소 하나 |
&arr + 1 | int[3] 배열 하나 |
7.6 배열의 초기화와 대입
배열은 선언하면서 초기화 할 수 있다
int arr[3] = {10, 20, 30};
int values[] = {1, 2, 3};
초기값 목록이 있으면 원소 수를 생략하여 컴파일러가 결정하게 할 수 있다
일부 원소에만 초기값을 지정하면 나머지는 0으로 초기화된다. 하지만 선언이 끝난 배얄에 초기값 목록을 다시 대입할 수는 없다
변경하려면 각 원소에 값을 대입해야 한다
arr[0] = 1;
arr[1] = 2;
7.7 배열 범위와 포인터 접근
원소가 3개인 배열에서 arr + 3은 마지막 원소 바로 다음 위치을 나타낸다. 이 포인터는 반복의 끝을 나타내는 용도로 만들 수 있지만, 간접 참조할 수는 없다
int arr[3] = {10, 20, 30};

int* end = arr + 3; // 가능: 배열 바로 다음 위치
*end;           // 잘못된 접근: 실제 원소가 없음
배열 범위를 벗어난 접근
배열의 유효한 원소 범위를 벗어나 값을 읽거나 쓰면 정의되지 않은 동작이 발생한다. 오류 메시지가 나오지 않더라도 올바른 접근이 아니다. 배열 바로 다음 위치의 포인터도 간접 참조하면 안 된다
- C 스타일 문자열과 문자열 리터럴
8.1 문자와 문자열
문자 하나는 char형 변수에 저장할 수 있다. 여러 문자로 이루어진 문자열은 문자 배열 등으로 표현한다
char ch = 'A';
char str[] = "Hello";| 구분 | 문자 | 문자열 |
|---|---|---|
| 표현 | 'A' | "Hello" |
| 따옴표 | 작은따옴표 | 큰따옴표 |
| 저장 형태 | 문자 하나 | 여러 문자와 종료 표시 |
'A'와 "A"도 다르다. "A"에는 문자 'A'뿐 아니라 문자열의 끝을 나타내는 널 문자 '\0'가 포함된다
8.2 C스타일 문자열과 널 문자
c 스타일 문자열(C-style String)
널 문자
'\0'로 끝나는 문자들의 연속이다. 문자 배열에 저장하거나, 포인터를 통해 접근할 수 있다
char str[] = "Hello";배열에는 다음과 같이 저장된다
| 인덱스 | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| 원소 | 'H' | 'e' | 'l' | 'l' | 'o' | '\0' |
'\0'는 값이 0인 문자이며, 숫자 모양의 문자 '0'과는 다르다
문자 배열이라고 해서 모두 C 스타일 문자열인 것은 아니다
char letters[3] = {'A', 'B', 'C'};
char text[4] = {'A', 'B', 'C', '\0'};letters에는 종료 표시가 없고, text에는 종료 표시가 있다
문자열의 종료 공간 확보
C 스타일 문자열에는 문자 데이터뿐 아니라 마지막
'\0'을 저장할 공간도 필요하다. 종료 표시가 없는 배열을 문자열 출력 함수에 전달하면 배열 범위를 넘어 읽는 문제가 발생할 수 있다
8.3 문자 배열의 선언과 초기화
8.3.1 배열 크기를 직접 지정
char str[0] = "Hello";문자 5개와 널 문자 1개가 저장된고, 나머지 원소도 0으로 초기화된다
8.3.2 초기값으로 배열 크기 결정
char str[] = "Hello";컴파일러가 널 문자까지 포함하여 배열 크기를 결정하므로, str은 원소가 6개인 배열이다
초기값 없이 일반적인 배열 정의에서 크기를 생략할 수는 없다
char str[]; // 오류: 배열 크기를 결정할 수 없음8.3.3 배열 크기와 문자열 길이
char str[10] = "Hello";| 구분 | 결과 |
|---|---|
| 배열 크기 | 10바이트 |
| 문자열 길이 | 5 |
| 문자열 저장에 필요한 최소 공간 | 6바이트 |
| 문자열 길이는 종료 널 문자를 제외하지만, 저장 공간에는 널 문자까지 포함해야 한다 |
8.4 문자열 리터럴과 포인터
문자열 리터러러(String Literal)
"Hello"처럼 큰따옴표로 작성한 문자열 상수이다. 일반적인 C++ 문자열 리터럴은 종료 널 문자를 포함하는const char배열이다
const char* ptr = "Hello";이 코드에서 ptr에는 문자열 리터럴의 첫 번째 문자를 가리키는 주소가 저장된다.
| 대상 | 역할 |
|---|---|
"Hello" | 문자들과 '\0'을 포함하는 문자열 리터럴 |
| ptr | 리터럴의 첫 문자를 가리키는 포인터 변수 |
ptr[0] | 첫 문자 'H'에 접근 |
문자열 리터럴은 프로그램 실행 동안 유지되며, 일반적으로 읽기 전용 메모리에 배치된다. 구체적인 저장 영역은 구현에 따라 다르지만 내용을 수정할 수 없다는 규칙은 동일하다
const char* ptr = "Hello";

ptr[0] = 'Y'; // 오류: const 문자를 수정할 수 없음
C++에서는 다음과 같이 문자열 리터럴을 char*에 직접 저장하는 형태를 사용하면 안 된다
char* ptr = "Hello"; // 표준 C++에서 허용되지 않음
const char* ptr = "Hello";
8.5 문자 배열과 문자열 포인터의 차이
char arr[] = "Hello";
const char* ptr = "Hello";
첫 번째는 초기 문자열을 복사하여 수정 가능한 배열을 만든다. 두 번째는 문자열 리터럴을 가리키는 포인터를 만든다
| 구분 | char arr[] = "Hello"; | const char* ptr = "Hello"; |
|---|---|---|
| 선언한 대상 | 문자 배열 | 포인터 변수 |
| 배열 원소 수정 | 가능 | ptr을 통해 수정 불가능 |
| 다른 문자열 주소 대입 | 불가능 | 가능 |
sizeof 결과 | 배열 전체 크기인 6 | 포인터 자체의 크기 |
8.5.1 문자 배열의 내용 변경
arr[0] = 'Y'; // "Yello"로 변경배열 전체에 새로운 문자열을 대입할 수는 없다. 각 원소를 변경하여 짧은 문자열로 만들 수 있다
arr[0] = 'H';
arr[1] = 'i';
arr[2] = '\0'; // 문자열은 "Hi"
이때 배열의 크기는 여전히 6이다. 문자열의 끝 위치가 바뀐 것이다
8.5.2 포인터가 가리키는 문자열 변경
const char* ptr = "Hello";
ptr = "Hi"; // 가능
이는 "Hello"의 내용을 수정하는 것이 아니라, ptr에 저장된 주소를 변경하여 다른 리터럴을 가리키게 하는 것이다
const char*에서 const는 가리키는 문자를 수정하지 못하게 한다. 포인터 변수 자체의 변경을 막는 것은 아니다
8.6 C 스타일 문자열의 출력
C 스타일 문자열을 출력할 때는 첫 문자부터 널 문자 직전까지 읽는다
char str[] = "Hello";

std::cout << str << '\n';std::cout은 char* 또는 const char*를 문자열로 처리하므로 위 코드는 주소 대신 Hello를 출력한다
C 형식의 출력에서는 %s를 사용한다
std::printf("%s\n", str);| 출력 방식 | 필요한 헤더 |
|---|---|
std::cout | <iostream> |
std::printf | <cstdio> |
문자 포인터의 주소 자체를 출력하려면 다음과 같이 변환할 수 있다
std::cout << static_cast<const void*>(str) << '\n';8.7 문자열 비교와 함수 전달
8.7.1 문자열 내용 비교
문자열 배열이나 문자 포인터에 ==를 사용하면 문자열 내용이 비교되는 것이 아니다
char a[] = "Hello";
char b[] = "Hello";

bool sameAddress = (a == b); // 서로 다른 배열의 시작 주소 비교
내용을 비교하려면 <cstring>의 std::strcmp() 등을 사용한다
bool sameText = (std::strcmp(a, b) == 0); // truestd::strcmp()의 결과가 0이면 두 C 스타일 문자열의 내용이 같다
8.7.2 문자열 리터럴의 함수 전달
std::printf("Age: %d\n", num);문자열 리터럴 "Age: %d\n"은 첫 번째 문자를 가리키는 포인터로 변환되어 전달된다. 따라서 printf()의 형식 문자열 매개변수는 const char* 형태이다
int printf(const char* format, ...);문자열 전체를 함수 인수로 복사하는 것이 아니라, 문자열에 접근할 수 있는 주소 값을 전달한다
9. 함수의 인수 전달과 배열 전달
9.1 인수와 매개변수
인수(Argument)와 매개변수(Parameter)
인수는 함수를 호출할 때 전달하는 값이나 식이고, 매개변수는 함수에서 전달받은 데이터를 사용하는 변수나 참조이다
void change(int value)
{
    value = 10;
}

int num = 5;
change(num);| 구분 | 해당 코드 |
|---|---|
| 인수 | 호출 시 전달하는 num |
| 매개변수 | 함수에 선언한 value |
함수 내부의 변경이 원본에 영향을 주는지 매개변수의 전달 방식에 따라 달라진다
9.2 값에 의한 전달
값에 의한 전달(Call-by-Value)
인수의 값을 복사하여 별도의 매개변수 객체에 전달하는 방식이다. 매개변수 자체를 변경해도 원본 변수는 변경되지 않는다
void change(int value)
{
	value = 10;
}
int num = 5;
change(num); // 호출 후에도 num은 5함수 호출 시 num의 값인 5가 value에 복사된다
| 시점 | 원본 num | 매개변수 value |
|---|---|---|
| 함수 진입 시 | 5 | 5 |
value = 10; 실행 후 | 5 | 10 |
num과 value는 서로 다른 객체이므로 매개변수에 대한 대입은 원본에 영향을 주지 않는다
함수는 호출자의 지역 변수 이름을 직접 사용할 수 없다. 다만 원본의 주소나 참조를 전달받으면 해당 갹체에 접근할 수 있다
9.3 포인터를 통한 원본 변경
원본을 변경하려면 원본의 주소를 전달하고, 함수에서 간접 참조할 수 있다
void change(int* ptr)
{
    *ptr = 10;
}
int num = 5;
change(&num); // 호출 후 num은 10| 코드 | 역할 |
|---|---|
&num | 원본의 주소를 구함 |
int* ptr | 전달받은 주소를 저장 |
*ptr = 10; | 해당 주소의 객체를 변경 |
이때도 주소 값 자체는 복사된다. 복사된 주소를 통해 같은 원본에 접근하기 때문에 원본의 값을 변경할 수 있다
포인터 전달도 값에 의한 전달이다
C의 함수 인수는 항상 값으로 전달된다. 포인터를 전달하는 경우에도 주소 값이 복사되며, 간접 참조를 통해 원본을 변경한다. C++의 참조 매개변수와 구분해야 한다
9.3.1 포인터 자체의 변경과 원본 변경
void redirect(int* ptr)
{
    ptr = nullptr;
}
int num = 5;
int* pnum = #
redirect(pnum);함수 안에서 지역 매개변수 ptr만 변경했으므로, 호출 후에도 pnum은 num을 가리킨다
9.4 참조에 의한 전달
참조에 의한 전달(Call-by-Reference)
매개변수를 참조형으로 선언하여 전달된 원본의 별칭으로 사용하는 방식이다
C++에서는 매개변수에 &를 붙여 참조형으로 선언할 수 있다
void change(int& ref)
{
    ref = 10;
}
int num = 5;
change(num); // 호출 후 num은 10ref는 num의 별칭이므로, ref에 대입하면 num이 변경된다
9.4.1 포인터 전달과 참조 전달 비교
| 구분 | 포인터 전달 | 참조 전달 |
|---|---|---|
| 매개변수 선언 | int* ptr | int& ref |
| 호출 | change(&num) | change(num) |
| 원본 접근 | *ptr | ref |
| 전달 방식 | 주소 값을 복사 | 원본의 별칭으로 사용 |
참조 전달에서는 호출할 때 인수 앞에 &를 붙이지 않는다. 같은 &라도 다음과 같이 역할이 다르다
int& ref = num; // 참조형 선언
#           // 주소를 구하는 연산
9.5 전달 방식 정리
| 방식 | 매개변수 | 전달되는 내용 | 매개변수를 통한 원본 값 변경 |
|---|---|---|---|
| 값 전달 | int value | 정수 값의 복사본 | 불가능 |
| 포인터 전달 | int* ptr | 주소 값의 복사본 | *ptr로 가능 |
| 참조 전달 | int& ref | 원본의 별칭 | ref로 가능 |
어떤 함수가 원본을 변경하는지 판단할 때는 매개변수 선언과 함수 내부에서 사용하는 표현을 함께 확인한다
9.6 배열의 함수 전달
일반적인 배열 매개변수에서는 배열 전체가 복사되지 않는다. 배열이 첫 번째 원소를 가리키는 포인터로 변환되어 전달된다
void changeFirst(int* arr)
{
    arr[0] = 100;
}
int numbers[3] = {10, 20, 30};
changeFirst(numbers);
// numbers는 {100, 20, 30}함수 안의 arr를 통해 원본 배열의 원소에 접근하므로 변경 내용이 원본에 반영된다
9.6.1 배열 매개변수 표기
다음 두 선언은 같은 함수 매개변수형을 나타낸다
void process(int arr[]);
void process(int* arr);
매개변수의 int arr[]는 int* arr로 조정된다
void process(int arr[10]);이렇게 크기를 적어도 원소가 반드시 10개인 배열만 전달하도록 검사하지 않는다. 배열 전체를 값으로 전달하는 선언도 아니다
9.6.2 배열 길이 함께 전달
포인터만으로는 원본 배열의 원소 수를 알 수 없으므로, 처리할 길이를 함께 전달한다
void process(int* arr, int length);int numbers[3] = {10, 20, 30};
process(numbers, 3);| 인수 | 전달하는 정보 |
|---|---|
| numbers | 첫 번째 원소의 주소 |
| 3 | 처리할 원소 수 |
읽기만 해야 하는 함수라면 다음과 같이 선언할 수 있다
void process(const int* arr, int length);9.6.3 함수 안에서의 sizeof
void process(int arr[], int length)
{
    // sizeof(arr)는 포인터의 크기
}
함수 매개변수 arr는 포인터이므로, sizeof(arr)로 원본 배열 전체 크기를 구할 수 없다
배열 전체 크기와 포인터 크기는 다르다는 점이 함수 전달에서도 그대로 적용된다
9.7 문자열과 포인터 배열의 전달
9.7.1 문자 배열 전달
C 스타일 문자열도 문자 배열이므로 첫 번째 문자의 주소를 전달할 수 있다
void printText(const char* text);char message[] = "Hello";
printText(message);
printText("Hello");문자열을 읽는 함수는 '\0'로 끝을 확인할 수 있지만, 포인터 자체에 문자열 길이가 저장되는 것은 아니다
9.7.2 포인터 배열 전달
문자열 포인터 여러 개를 배열에 저장할 수도 있다
const char* words[] = {"Hello", "World"};words의 각 원소는 const char*형이다. 이 배열을 전달하면 첫 번째 포인터 원소를 가리키는 포인터로 변환된다
void processWords(const char** words, int count);processWords(words, 2);| 표현 | 의미 |
|---|---|
words | 첫 번째 포인터 원소를 가리키는 포인터 |
words[0] | 첫 문자열의 시작 주소 |
words[1] | 두 번째 문자열의 시작 주소 |
words[0][0] | 첫 문자열의 첫 문자 'H' |
이러한 포인터 배열은 2차원 문자 배열과 다른 자료형이다. 2차원 배열을 임의로 char**에 전달할 수는 없다
10. C++ 문자열과 입출력
10.1 C++ 문자열 std::string
std::stringC++ 표준 라이브러리가 제공하는 문자열 클래스이다. 문자열의 저장 공간을 관리하며, 복사, 비교, 연결, 검색 등의 기능을 제공한다
std::string을 사용하려면 <string> 헤더를 포함한다
#include <string>

std::string text = "Hello";
std::string empty; // 빈 문자열std::string은 문자열 길이에 맞추어 저장 공간을 관리하므로, 문자 배열처럼 고정된 크기를 직접 지정할 필요가 없다
| 구분 | C 스타일 문자열 | std::string |
|---|---|---|
| 표현 방식 | 널 문자로 끝나는 문자들의 연속 | 문자열 객체 |
| 길이 관리 | 널 문자 위치 등으로 확인 | size(), length() 제공 |
| 내용 복사 | 별도의 복사 처리 필요 | = 사용 가능 |
| 내용 비교 | strcmp() 등 사용 | ==, < 등 사용 가능 |
| 문자열 연결 | 공간 확보와 복사 처리 필요 | +, += 사용 가능 |
10.2 문자열의 복사와 원소 접근
10.2.1 문자열 복사
std::string은 대입이나 초기화를 통해 내용을 복사할 수 있다
std::string str1 = "Hello";
std::string str2 = str1;

str1[0] = 'Y';| 문자열 | 최종 내용 |
|---|---|
| str1 | "Yello" |
| str2 | "Hello" |
str2는 별도의 문자열 객체이므로, str1을 수정해도 함께 변경되지 않는다
이미 존재하는 문자열에 새 내용을 대입할 수도 있다
str1 = "Hi";이는 배열 전체에 문자열을 대입할 수 없는 char 배열과 다른 점이다
10.2.2 인덱스로 문자 접근
문자열의 인덱스는 0부터 시작한다
std::string text = "Hello";

text[0]; // 'H'
text[1]; // 'e'
text[4]; // 'o'
문자 내용을 읽거나 변경할 때는 0부터 size() - 1까지의 유효한 인덱스를 사용한다
text[0] = 'Y'; // "Yello"[]는 일반적인 범위 검사를 수행하지 않는다. 범위를 검사하는 접근이 필요하면 at()을 사용할 수 있으며, 범위를 벗어나면 예외가 발생한다
10.3 문자열의 길이
size()와 length()는 문자열에 저장된 문자 요소의 수를 반환한다
std::string text = "Hello";

text.size();   // 5
text.length(); // 5| 표현 | 의미 |
|---|---|
text.size() | 문자열의 길이 |
text.length() | 문자열의 길이 |
sizeof(text) | std::string 객체 자체의 크기 |
sizeof(text)는 저장된 문자열의 길이가 아니다
빈 문자열의 길이는 0이며, empty()로 비어 있는지 확인할 수 있다
std::string text;

text.size();  // 0
text.empty(); // truestd::string의 길이는 char 요소의 수이므로, UTF-8 한글처럼 여러 바이트로 표현되는 문자는 화면에 보이는 글자 수와 결과가 다를 수 있다
10.4 문자열 비교와 연결
10.4.1 내용 비교
std::string에 비교 연산자를 사용하면 문자열의 내용을 비교한다
std::string a = "apple";
std::string b = "apple";

a == b; // true
a != b; // false
<, <=, >, >=는 문자를 앞에서부터 비교하는 사전식 비교를 수행한다
std::string a = "apple";
std::string b = "banana";

a < b; // true
사전식 비교는 문자열 길이만 비교하는 것이 아니다. 처음으로 다른 문자에서 순서를 결정하고, 한쪽이 다른 쪽의 접두사라면 짧은 쪽이 앞선다
10.4.2 문자열 연결
+는 연결한 새 문자열을 만들고, +=는 기존 문자열 뒤에 내용을 추가한다
std::string first = "Hello";
std::string second = "World";

std::string message = first + " " + second;
// message는 "Hello World"

first += "!";
 // first는 "Hello!"
두 문자열 리터럴에 직접 +를 적용할 수는 없다
"Hello" + "World"; // 오류연결 연산에 std::string 객체를 포함하면 된다
std::string message = std::string("Hello") + "World";10.5 문자열 검색과 부분 문자열
10.5.1 find() — 검색
문자나 부분 문자열을 찾아 처음 일치하는 위치의 인덱스를 반환한다
std::string text = "I like apples and oranges.";

auto pos = text.find("and"); // 14
auto letter = text.find('l'); // 2
두 번째 인수로 검색 시작 위치를 지정할 수 있다
text.find("and", 15); // 인덱스 15부터 검색찾지 못하면 std::string::npos를 반환한다
auto pos = text.find("banana");

if (pos == std::string::npos)
{
    // 찾지 못함
}
검색 실패는
npos로 확인
find()의 반환형은 문자열의 크기와 위치를 표현하는 부호 없는 정수형이다. 결과를int에 저장하여-1과 비교하기보다,auto로 받고std::string::npos와 비교하는 것이 명확하다
10.5.2 substr() — 부분 문자열 추출
지정한 위치부터 일부 내용을 복사한 새 문자열을 반환한다. 원본은 변경하지 않는다
std::string text = "I like apples and oranges.";

text.substr(2, 4); // "like"
text.substr(2); // "like apples and oranges."| 호출 | 의미 |
|---|---|
substr(pos, count) | pos부터 최대 count개 추출 |
substr(pos) | pos부터 끝까지 추출 |
시작 위치가 문자열 길이보다 크면 예외가 발생한다
10.6 문자열 수정
10.6.1 replace() — 교체
지정한 위치부터 일정 개수의 문자를 다른 문자열로 교체한다
std::string text = "I like apples.";

text.replace(2, 4, "love");
// "I love apples."| 인수 | 의미 |
|---|---|
| 2 | 교체 시작 인덱스 |
| 4 | 제거할 기존 문자 수 |
"love" | 새로 넣을 문자열 |
기존 문자 수와 새 문자열 길이가 같을 필요는 없다
10.6.2 insert() — 삽입
지정한 위치의 앞에 문자열을 삽입한다
text.insert(2, "really ");
// "I really love apples."| 함수 | 원본 변경 여부 |
|---|---|
find() | 변경하지 않음 |
substr() | 변경하지 않음 |
replace() | 변경함 |
insert() | 변경함 |
10.7 스트림 입출력
스트림(Stream)
프로그램과 입력 또는 출력 대상 사이에서 데이터가 순서대로 흐르는 통로를 나타내는 개념이다
C++의 기본적인 콘솔 입출력에는 <iostream>을 사용한다
| 요소 | 역할 |
|---|---|
std::cin | 표준 입력 스트림 |
std::cout | 표준 출력 스트림 |
>> | 스트림에서 값을 추출하여 변수에 저장 |
<< | 값을 스트림에 삽입하여 출력 |
int num;

std::cin >> num;
std::cout << "Number: " << num << '\n';
C++에서도 C 스타일의 printf(), scanf()를 사용할 수 있다. 다만 각각 필요한 헤더와 형식에 맞게 사용해야 한다
10.7.1 여러 값 입력
>>를 연속해서 사용하면 여러 값을 입력받을 수 있다
int count;
double value;

std::cin >> count >> value;
숫자 입력에서 공백, 탭, 줄 바꿈은 일반적으로 값 사이의 구분자로 처리된다
10.7.2 std의 의미
std는 C++ 표준 라이브러리의 이름들이 속하는 네임스페이스이다
std::string text;
std::cout << text;std::는 해당 이름을 std 네임스페이스에서 찾도록 지정한다
10.7.3 줄 바꿈
std::cout << "Hello\n";
std::cout << "Hello" << std::endl;
두 표현 모두 줄을 바꾸지만, std::endl은 출력 버퍼를 비우는 동작도 수행한다. 단순히 줄만 바꾸려면 '\n'을 사용할 수 있다
10.8 문자열 입력과 getline()
10.8.1 >>를 이용한 문자열 입력
std::string text;
std::cin >> text;
앞의 공백을 건너뛰고, 다음 공백 문자를 만나기 전까지 읽는다. 입력이 다음과 같다면:
Hello Worldtext에는 "Hello"만 저장된다
10.8.2 std::getline()으로 한 줄 입력
공백을 포함한 한 줄을 std::string에 저장하려면 다음과 같이 사용한다
std::string text;
std::getline(std::cin, text);
입력이 Hello World라면 전체가 저장된다. 기본적으로 줄 바꿈 문자를 만나면 입력을 마치며, 줄 바꿈 문자는 소비하지만 문자열에는 저장하지 않는다
10.8.3 std::cin.getline()으로 문자 배열 입력
문자 배열에 한 줄을 입력할 때는 스트림의 멤버 함수인 getline()을 사용할 수 있다
char text[20];
std::cin.getline(text, 20);
두 번째 인수는 널 문자 공간을 포함한 저장 한도이다. 따라서 최대 19개의 문자를 저장하고 마지막에 '\0'을 붙인다
한도를 초과하는 줄은 한 번에 모두 저장되지 않으며, 입력 스트림에 실패 상태가 설정될 수 있다
| 구분 | std::getline(std::cin, text) | std::cin.getline(text, size) |
|---|---|---|
| 저장 대상 | std::string | 문자 배열 |
| 저장 한도 지정 | 일반적인 호출에서는 지정하지 않음 | 배열 공간에 맞게 지정 |
| 종료 널 문자 직접 관리 | 필요 없음 | 함수가 추가 |
10.8.4 >> 다음에 한 줄 입력
숫자 등을 >>로 입력받은 뒤에는 줄 바꿈이 입력 스트림에 남을 수 있다
int age;
std::string name;

std::cin >> age;
std::getline(std::cin, name);
이 경우 getline()이 남아 있는 줄 바꿈을 바로 읽어 빈 문자열을 얻을 수 있다
숫자 입력이 성공했다는 전제에서, 현재 줄의 나머지를 버린 뒤 다음 줄을 읽을 수 있다
std::cin.ignore(
    std::numeric_limits<std::streamsize>::max(),
    '\n'
);

std::getline(std::cin, name);std::numeric_limits를 사용하려면 <limits>를 포함한다