1. 데이터베이스
데이터베이스
서로 관련이 있는 데이터를 체계적으로 모아 저장한 집합이다
예를 들어, 학생 정보를 저장하는 데이터베이스, 아마존의 상품 정보를 저장하는 데이터베이스, 항공 예약 정보를 저장하는 데이터베이스 등이 있다
1.1 데이터베이스 관리 시스템
데이터베이스 관리 시스템(Database Management System, DBMS)
데이터베이스의 구조를 정의하고 데이터를 저장, 조회, 수정, 삭제하며, 접근 권한, 무결성, 동시성, 복구 등을 관리하는 소프트웨어이다
DBMS는 많은 데이터를 효율적으로 관리하고, 저장된 데이터를 장기간 유지할 수 있도록 한다. 데이터베이스는 저장된 데이터의 집합이고, DBMS는 이를 관리하는 소프트웨어이다
DBMS 및 관련 서비스의 예시는 다음과 같다. 아래 구분은 상용 여부, 제공 방식, 구현 형태를 기준으로 하므로 서로 겹칠 수 있다
| 구분 | 예시 |
|---|---|
| 상용 DBMS | Oracle, IBM DB2, Microsoft SQL Server |
| 클라우드 데이터베이스·분석 서비스 | Snowflake, AWS Redshift, Google BigQuery, SQL Azure |
| 오픈소스 DBMS | MySQL, PostgreSQL, DuckDB |
| 라이브러리 형태의 오픈소스 DBMS | SQLite |
1.2 데이터 모델
데이터 모델
데이터의 구조와 관계, 데이터에 적용할 수 있는 연산 및 제약 조건을 정의하는 개념적 틀이다
DBMS가 데이터를 관리하려면 데이터를 어떤 구조로 표현하고 다룰지 정의하는 데이터 모델이 필요하다. 데이터 모델에는 다음과 같은 종류가 있다
- 관계형 모델(Relational Model)
- 반구조화 모델(Semi-structured Model)
- 키–값 모델(Key–Value Model)
- 그래프 모델(Graph Model)
- 객체 지향 모델(Object-oriented Model)
이 수업에서는 관계형 모델을 중심으로 다룬다
2. 관계형 모델
관계형 모델(Relational Model)
데이터를 행과 열로 구성된 릴레이션(Relation)으로 표현하는 데이터 모델이다
기본 특징
- 데이터를 행과 열로 이루어진 2차원 테이블로 표현한다
- 집합 단위의 질의 언어(Query Language)를 사용해 데이터를 조회한다
- 데이터의 논리적 구조를 정의하며, 물리적인 저장 방식은 규정하지 않는다
2.1 관계형 모델의 용어
관계형 모델에서는 테이블, 열, 행을 다음과 같은 용어로 표현한다
| 구성 요소 | 관련 용어 | 의미 |
|---|---|---|
| 테이블 | Table, Relation(릴레이션) | 같은 속성 구조를 갖는 튜플들의 집합이다 |
| 열 | Column, Attribute(속성), Field | 이름, 학번 등 데이터의 특성을 나타낸다 |
| 행 | Row, Tuple(튜플), Record | 각 속성에 대응하는 값들로 이루어진 하나의 데이터 항목이다 |
예를 들어, 다음과 같은 학생 테이블이 있다고 하자
| 학번 | 이름 | 학과 |
|---|---|---|
| 2026001 | 김민수 | 컴퓨터공학과 |
| 2026002 | 이지연 | 경영학과 |
- 릴레이션: 학생 테이블 전체
- 속성: 학번, 이름, 학과
- 튜플:
2026001, 김민수, 컴퓨터공학과처럼 한 행을 구성하는 값들의 묶음
2.2 스키마, 인스턴스, 질의 언어
데이터 모델과 데이터베이스를 이해할 때 다음 세 가지 개념을 구분해야 한다
| 개념 | 의미 |
|---|---|
| 스키마(Schema) | 데이터베이스의 구조를 정의한 것으로, 테이블, 속성, 데이터 타입, 제약 조건 등을 포함한다 |
| 인스턴스(Instance) | 특정 시점에 데이터베이스에 저장되어 있는 실제 데이터 값이다 |
| 질의 언어(Query Language) | 저장된 데이터를 조회하고 조작하기 위한 언어이다 |
스키마는 데이터의 구조이고, 인스턴스는 그 구조에 따라 저장된 실제 내용이다
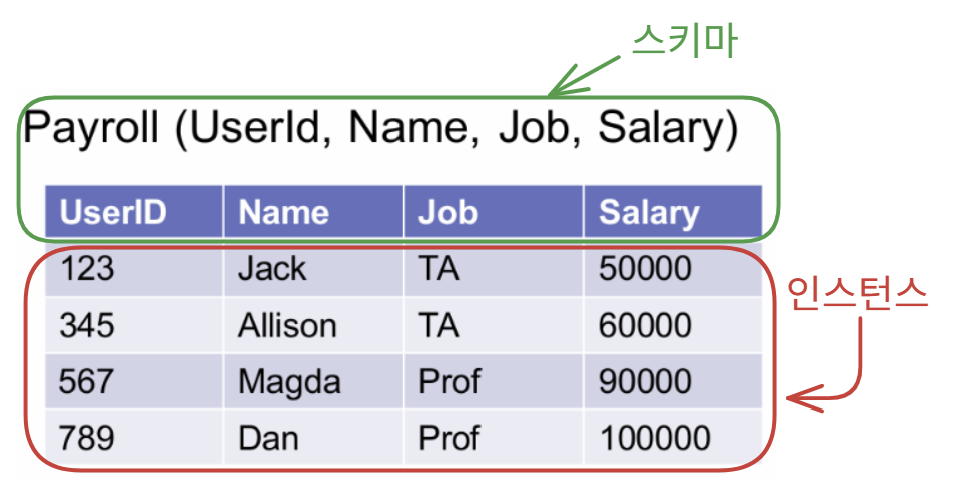
예를 들어, Payroll 테이블에 문자열 타입의 Name 속성이 있다는 정의는 스키마의 일부이며, 특정 시점에 저장된 전체 행들은 해당 테이블의 인스턴스를 구성한다
다음은 Payroll 테이블에서 Name 속성의 값을 조회하는 질의이다
SELECT Name
FROM Payroll;
스키마는 일반적인 데이터 삽입, 수정, 삭제 중에는 유지되지만, 별도의 구조 변경 명령으로 변경할 수 있다. 반면 인스턴스는 데이터 조작에 따라 자주 바뀐다
2.3 관계형 모델의 특성
2.3.1 순서 무관
- 튜플의 순서는 릴레이션의 의미에 영향을 주지 않는다
- 속성을 이름으로 구분하므로, 속성을 나열하는 순서도 릴레이션의 의미에 영향을 주지 않는다
즉, 행이나 열의 표시 순서가 달라져도 동일한 속성과 값의 대응 관계를 유지하면 같은 정보를 나타낸다
2.3.2 중복 튜플 불가
- 수학적 관계형 모델에서 릴레이션은 집합(Set)이므로 동일한 튜플을 중복해서 포함할 수 없다
- 동일한 튜플이란 모든 속성의 값이 같은 행을 뜻한다
- 특정 속성의 값만 같다는 이유로 중복 튜플이 되는 것은 아니다
예를 들어, 이름이 같은 학생이 두 명 있더라도 학번이 다르면 서로 다른 튜플이다
실제 SQL 기반 DBMS에서는 테이블의 제약 조건이나 질의 방식에 따라 중복 행이 허용될 수 있다. 이처럼 중복을 허용하는 컬렉션을 백(Bag) 또는 다중집합(Multiset)이라고 한다 🔴<- 링크 수정 필요 4 추가되면
2.3.3 속성의 데이터 타입
- 모든 속성에는 데이터 타입이 정해져 있다
- 같은 열에 속하는 값들은 해당 열에 정의된 타입을 따른다
- 각 속성의 값은 정해진 타입에 맞아야 한다
예를 들어, 나이를 정수형으로 정의했다면 해당 속성에는 정수형으로 표현할 수 있는 값이 저장되어야 한다
2.3.4 평면 구조와 원자성
- 기본 관계형 모델에서 각 셀은 하나의 원자적인 값을 가진다
- 원자적인 값이란 해당 모델에서 하나의 값으로 취급하는 단위를 뜻한다
- 셀 안에 또 다른 테이블이나 중첩된 하위 테이블을 넣지 않는다
여기서 원자성은 속성값의 구조에 관한 의미이다
2.3.5 스키마와 튜플의 구조 일치
- 같은 릴레이션 안에서 속성 이름은 서로 달라야 한다
- 각 튜플은 스키마에 정의된 속성 개수와 같은 개수의 값을 가져야 한다
- 각 값은 대응하는 속성의 데이터 타입에 맞아야 한다
예를 들어, 다음 스키마의 각 튜플은 정수·문자열·정수에 해당하는 세 개의 값으로 구성되어야 한다
saddress(num integer, street text, zip integer)
3. 데이터 추상화와 데이터 독립성
3.1 데이터베이스의 3단계 스키마
데이터베이스는 사용자에게 보이는 모습, 전체 데이터의 논리적 구조, 실제 저장 구조를 구분하여 설명할 수 있다
3단계 스키마
데이터베이스의 구조를 외부 스키마, 개념 스키마, 내부 스키마로 나누는 구조이다. 사용자별 관점과 전체 논리 구조, 물리적 저장 구조를 구분한다
| 단계 | 의미 | 예시 |
|---|---|---|
| 외부 스키마 | 특정 사용자나 애플리케이션에 필요한 데이터의 모습 | 과목별 수강 인원만 보여 주는 뷰 |
| 개념 스키마 | 데이터베이스 전체의 논리적 구조 | 학생, 과목, 수강 테이블과 제약조건 |
| 내부 스키마 | 데이터를 실제로 저장하고 접근하는 구조 | 파일 구성, 인덱스, 저장 방식 |
외부 스키마는 사용자나 용도에 따라 여러 개가 있을 수 있다
같은 대학 데이터베이스라도 학생은 자신의 수강 내역을, 교수는 담당 과목의 수강생 정보를 볼 수 있다. 두 사용자가 서로 다른 정보를 보더라도 기반이 되는 데이터베이스는 같다
개념 스키마와 개념적 설계의 구분
여기서 개념 스키마는 데이터베이스 전체의 논리적 구조를 뜻한다. 설계 단계에서 ER 다이어그램을 만드는 개념적 설계와 관련은 있지만, 두 용어를 완전히 같은 뜻으로 사용하지는 않는다
3.2 대학 데이터베이스 예시
대학 데이터베이스의 전체 논리적 구조가 다음과 같다고 하자
Students(sid, name, login, age, gpa)Courses(cid, cname, credits)Enrolled(sid, cid, grade)
각 테이블은 다음 정보를 저장한다
| 테이블 | 저장하는 정보 |
|---|---|
| Students | 학생의 학번, 이름, 로그인 정보, 나이, 평점 |
| Courses | 과목 번호, 과목명, 학점 |
| Enrolled | 학생의 수강 과목과 성적 |
이러한 테이블과 속성, 키와 제약조건에 대한 정의가 개념 스키마에 해당한다
3.2.1 외부 스키마
과목별 수강 인원만 필요한 사용자를 위해 다음 뷰를 제공할 수 있다
CREATE VIEW Course_info AS
SELECT c.cid, COUNT(e.sid) AS enrollment
FROM Courses AS c
LEFT JOIN Enrolled AS e
    ON c.cid = e.cid
GROUP BY c.cid;
사용자는 다음과 같이 조회한다
SELECT cid, enrollment
FROM Course_info;
이 사용자는 학생의 나이나 평점 등을 직접 다루지 않고, 필요한 과목 번호와 수강 인원만 조회한다
3.2.2 내부 스키마
같은 테이블을 실제로 저장할 때는 다음과 같은 사항을 정한다
- 테이블 데이터를 어떤 파일과 페이지에 저장할 것인가?
- 학생을 학번으로 빠르게 찾기 위해 인덱스를 만들 것인가?
- 데이터를 어떤 저장 구조로 관리할 것인가?
예를 들어 학번에 인덱스를 추가하더라도 Students가 학생 정보를 나타낸다는 논리적 의미는 그대로이다